跳至正文
-
复杂世界,看图就懂!
做个明白人 - 复杂世界,看图就懂 做个明白人 - 复杂世界,看图就懂 做个明白人

复杂世界,看图就懂

做个明白人 - 复杂世界,看图就懂 做个明白人 - 复杂世界,看图就懂 做个明白人

复杂世界,看图就懂

  • 首页
  • 行业拆解
    • 医疗健康
    • 食品消费
    • 金融保险
    • 房产中介
    • AI与新技术
    • 教育培训
    • 旅游景点
  • 精打细算
    • 财务理财
      • 贷款还款
      • 保险养老
      • 存款投资
    • 税务与经营
      • 企业税费
      • 工资税务
      • 电商经营
  • 首页
  • 行业拆解
    • 医疗健康
    • 食品消费
    • 金融保险
    • 房产中介
    • AI与新技术
    • 教育培训
    • 旅游景点
  • 精打细算
    • 财务理财
      • 贷款还款
      • 保险养老
      • 存款投资
    • 税务与经营
      • 企业税费
      • 工资税务
      • 电商经营
关

搜索

做个明白人 - 复杂世界,看图就懂 做个明白人 - 复杂世界,看图就懂 做个明白人

复杂世界,看图就懂

做个明白人 - 复杂世界,看图就懂 做个明白人 - 复杂世界,看图就懂 做个明白人

复杂世界,看图就懂

  • 首页
  • 行业拆解
    • 医疗健康
    • 食品消费
    • 金融保险
    • 房产中介
    • AI与新技术
    • 教育培训
    • 旅游景点
  • 精打细算
    • 财务理财
      • 贷款还款
      • 保险养老
      • 存款投资
    • 税务与经营
      • 企业税费
      • 工资税务
      • 电商经营
  • 首页
  • 行业拆解
    • 医疗健康
    • 食品消费
    • 金融保险
    • 房产中介
    • AI与新技术
    • 教育培训
    • 旅游景点
  • 精打细算
    • 财务理财
      • 贷款还款
      • 保险养老
      • 存款投资
    • 税务与经营
      • 企业税费
      • 工资税务
      • 电商经营
关

搜索

AI与新技术

2026年AI大模型综合实力排行:中国模型上榜,榜单也在换评分逻辑

2026年10月8日 1 分钟阅读
0

看到这份AI大模型综合实力排行时,第一反应不是“谁又拿第一了”,而是评测方式确实变了。蓝紫背景、左右两列、从第1到第25的模型名单,Anthropic、OpenAI、Alibaba、Moonshot AI、Zhipu AI 这些机构被放在同一个坐标系里。分数不是唯一看点,排名方法 BenchAlign v5.2、数据核验日期 2026.09.10、BenchLM 榜单入口,这些细节说明它更像一张“能力体检表”,而不是单纯的人气投票。
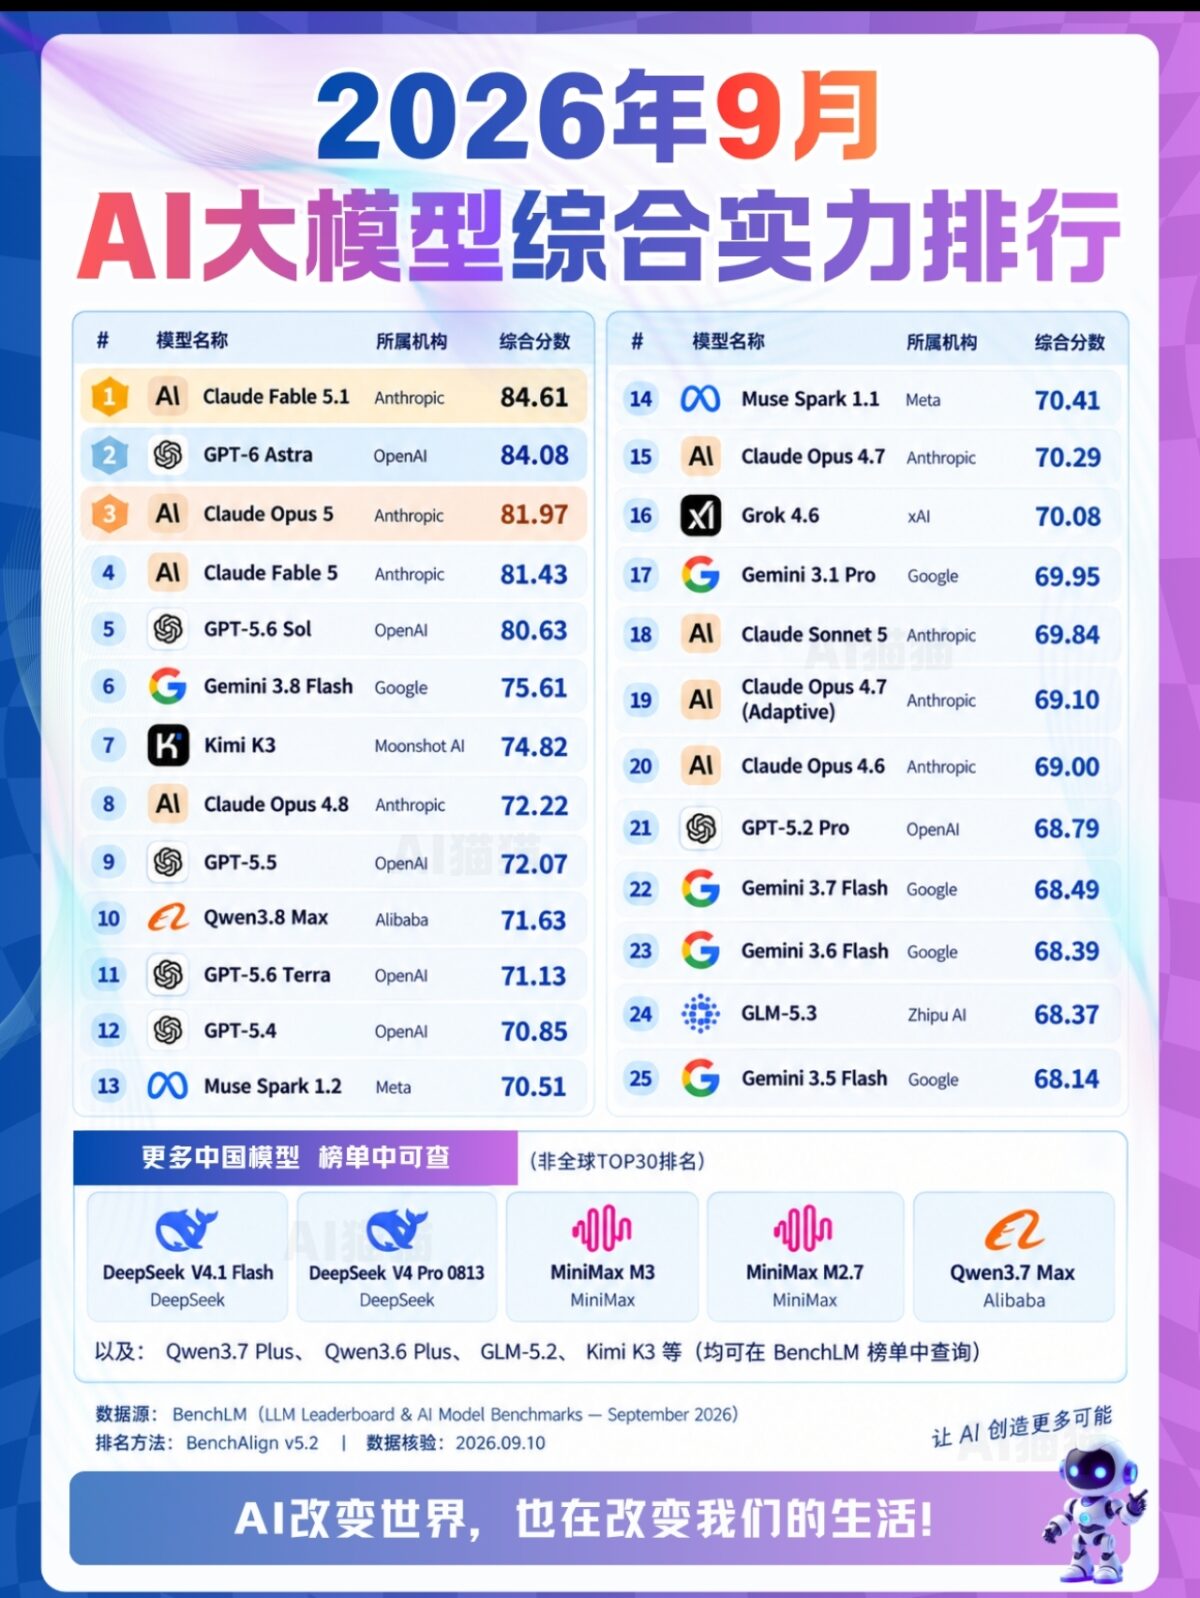
2026年9月AI大模型综合实力排行信息图表,展示Claude、GPT、Qwen、Kimi等模型排名与BenchLM评测信息

这份 AI大模型综合实力排行,先别只盯前三名

前三名里,Claude Fable 5.1 拿到 84.61,GPT-6 Astra 是 84.08,Claude Opus 5 为 81.97。差距很小,基本咬在一起。这样的头部格局挺有意思:不是某一家把分数甩开一大截,而是几个模型在不同能力项上轮流占优。对开发者来说,选模型时更可能按场景切,而不是无脑选“最高分”。

中国模型也没缺席。Qwen3.8 Max、Kimi K3 进入榜单前列,GLM-5.3 也在中后段出现。下方“更多中国模型 榜单中可查”还列了 DeepSeek V4.1 Flash、MiniMax M3、Qwen3.7 Max 等。这个专区其实透露了一个信号:中国 AI 厂商不只是靠一两个明星模型刷榜,而是开始形成可被持续检索、对比的模型矩阵。

AI大模型综合实力排行背后,拼的不再只是“会说”

如果只看分数,很容易误以为榜单还是在比谁更像聊天机器人。但AI大模型综合实力排行这个名字本身,已经暗示了评分维度。BenchAlign 这类方法如果进入 v5.2,通常意味着评测从单点能力往综合智能靠:长任务拆解、多轮一致性、工具调用、代码与数学、长文本理解、安全对齐,可能都被揉进总分。

这也解释了为什么不同模型会出现在不同位置。一个擅长短对话的模型,不一定能稳定完成复杂工作流;一个通用能力强的模型,也不一定在中文场景里最顺手。未来用户真正关心的,可能是“它能不能把活干完”,而不是“它说话像不像人”。

中国模型的看点,藏在“能不能落地”

榜单里提到 Alibaba、Moonshot AI、Zhipu AI、DeepSeek、MiniMax 等,这些机构过去几年都在做同一件事:把模型能力压进具体产品。Qwen 系列在开发者生态里常见,Kimi 对长文本和搜索增强有用户认知,GLM 在行业场景里持续迭代,DeepSeek 则因为推理和效率路线被大量讨论。它们在榜单上出现,不只是分数问题,也意味着这些路线被评测体系看见了。

更现实的一点是,模型排名越高,不等于商业价值越高。真正改变工作的,往往是稳定、便宜、能接入现有流程。一个 70 多分的模型,如果响应快、上下文长、中文表达自然,在客服、办公、代码辅助里照样有竞争力。

从榜单到生活,AI开始变成基础设施

图表右下角那句“AI改变世界,也在改变我们的生活!”看着像口号,但放在这张榜单旁边,有点落地的意思。模型被排到第几名,对普通用户不一定重要;重要的是这些模型会不会进入文档助手、搜索、编程工具、教育应用、企业知识库,最后变成日常软件背后的默认选项。

这份AI大模型综合实力排行真正值得看的,是它给出了一张阶段地图。头部模型互相咬住,中国模型进入可比区间,评测体系从单一分数转向综合能力。接下来几年,AI大模型的竞争可能不再是谁先发布新模型,而是谁能把复杂能力变成稳定服务,让开发者少踩坑,让普通用户少解释需求。

榜单会更新,分数会变,模型名称也会不断换代。但方向已经很清楚:AI大模型正在从“会回答”走向“会做事”,从发布会上的演示走向办公、学习、开发和行业流程里。下一次再看排行,可能更要问一句:它到底能不能替人把活干完?
标签:

AI大模型中国AI综合实力排行
作者

东大

关注我
其他文章
深色科技背景的未来就业趋势信息图,左侧黄色上升箭头显示增长岗位,右侧红色下降箭头显示下降岗位,标题为未来5年哪些岗位最危险
上一个

AI重塑未来就业趋势:哪些岗位危险,哪些岗位增长?

下一个

银行存款利息计算器

暂无评论!成为第一个。

发表回复 取消回复

您的邮箱地址不会被公开。 必填项已用 * 标注

近期文章

  • 100元人民币购买力:在津巴布韦买土豆,在瑞士只买?
  • 十二个月最佳旅行目的地清单里,为什么有的城被点名四次?
  • 史上最聪明十人:诸葛亮只排第五,第一凭什么是鬼谷子
  • 计算机证书“段位表”曝光:软考高级凭啥标年薪40万?
  • 从“盖房子”到“六只鸡”:100元购买力的年代变迁

近期评论

您尚未收到任何评论。

归档

  • 2026 年 11 月 (2)
  • 2026 年 10 月 (83)
  • 2026 年 9 月 (32)

热门词库

100元人民币购买力 100元购买力 AI应用 iPhone 中国AI 人工智能 传统行业改造 兴趣分级 养老定居 养老规划 出境游 十二个月目的地清单 厂商认证 历史谋士 各国物价 女性形象 季节出行规划 宜居环境 年代变迁 慢生活 户外徒步 户外打卡 技术革命 择偶观 排行榜 时代红利 最佳旅行时间 海拔排行 深圳十峰 物价 电池容量 登山攻略 社会毕业 科技风口 职业排行榜 自嘲式梗图 自律 苏东坡 计算机证书 认知成长 诸葛亮 资产配置 软考 长寿城市 鬼谷子

关于我们

  • 关于我们
  • 联系我们
  • 隐私政策

分类

  • 行业拆解
  • 资源库
Copyright 2026 — 做个明白人. All rights reserved.